← 전체 프로젝트

01. 한 줄로 보는 REMAKE DAY

REMAKE DAY

LLM NPC 추리 게임을, AI 제안을 사람이 어떻게 받아들이는지 기록하는 Human–AI 실험환경으로 설계한 프로젝트 — 원티드 AI Championship 2026

기간
2026-09-01 ~ 진행 중
팀 · 역할
5명 · AI Evaluation Engineer (평가 설계·러너·provider 어댑터·배포 지표)
  • FastAPI
  • Next.js
  • PostgreSQL · pgvector
  • Ollama Gemma 4
  • Claude API
  • Gemini 임베딩
  • Jekyll
REMAKE DAY 대표 화면

↓ 스크롤 또는 ← → 키로 넘기기

02. 설계 원칙 - 합격선을 먼저, 모든 후보를 같은 시험으로

팀에서 평가 설계를 맡았습니다. GPU 16GB 한 장에 추리용 Core와 대화용 NPC가 함께 올라가야 했기에, "누가 더 똑똑한가"보다 "같이 상주할 수 있는가"부터 결정적 게이트로 판정했습니다.
문제
GPU 한 장에 Core와 NPC 두 모델이 동시에 올라가야 한다 — 벤치마크 점수가 좋아도 같이 못 올라가면 쓸 수 없다
선택
스키마 준수 · 누설 · 지연 p95 · 동시 상주 · 루프 완주를 합격선으로 먼저 정하고 모든 후보를 같은 조건으로 측정. 실패 비용이 큰 Core를 먼저 확정한 뒤 NPC
대가
1차에서는 LLM 심판을 쓰지 않아 대화의 의미 품질은 좁게만 봤다
효과
Core + NPC 동시 상주 12.34 GiB (GPU 81.7%) 확정. NPC 41문답 실패 0 · 중간값 2.599초
GPU 예산과 결정적 게이트 (도식)

왜 이 선택인가 — 버린 대안

  • 한 모델을 Core · NPC에 공유
    메모리는 아끼지만 두 역할의 품질 문제가 얽히고 컨텍스트 길이가 부족했다
  • 모델 파일 크기로 메모리 예산 추정
    실제 상주량과 크게 어긋났다 — 실측으로 바꿈

결정적 게이트란?

사람의 인상 대신 통과 · 실패가 분명한 기준(형식을 지켰나, 정답을 흘렸나, 몇 초 안에 답했나)으로 모델을 거르는 방식입니다. 기준을 먼저 공개해 두면 결과를 보고 기준을 바꿨다는 의심을 받지 않습니다.

근거: docs/model_evaluation.md — E7 · E6

03. 채점에서 검색을 뺐다

플레이어가 정답에 닿아도 점수가 21~42%에 머물렀습니다. 원인은 임베딩 유사도 상위 3개만 심판 모델에 넘기던 검색 단계였고, 후보가 8개뿐이라 전부 넘기는 쪽이 정확했습니다.
문제
정답을 말해도 점수가 낮다 — 정답 근거가 유사도 4위 이하로 밀리면 심판이 아예 보지 못했다
선택
주장 8개를 번호 목록으로 전부 심판에게 전달. 임베딩은 "규칙 대안 추천 순위" 한 자리에만 되살리고, 실패하면 어간 비교로 폴백
대가
준비해 둔 벡터 테이블은 채점에서 쓰이지 않게 됐다
효과
정답형 점수 65.3 → 100.0, 오답형 25.7 → 19.4. 추천 순위 top-1 어간 비교 0.300 → 임베딩 0.967
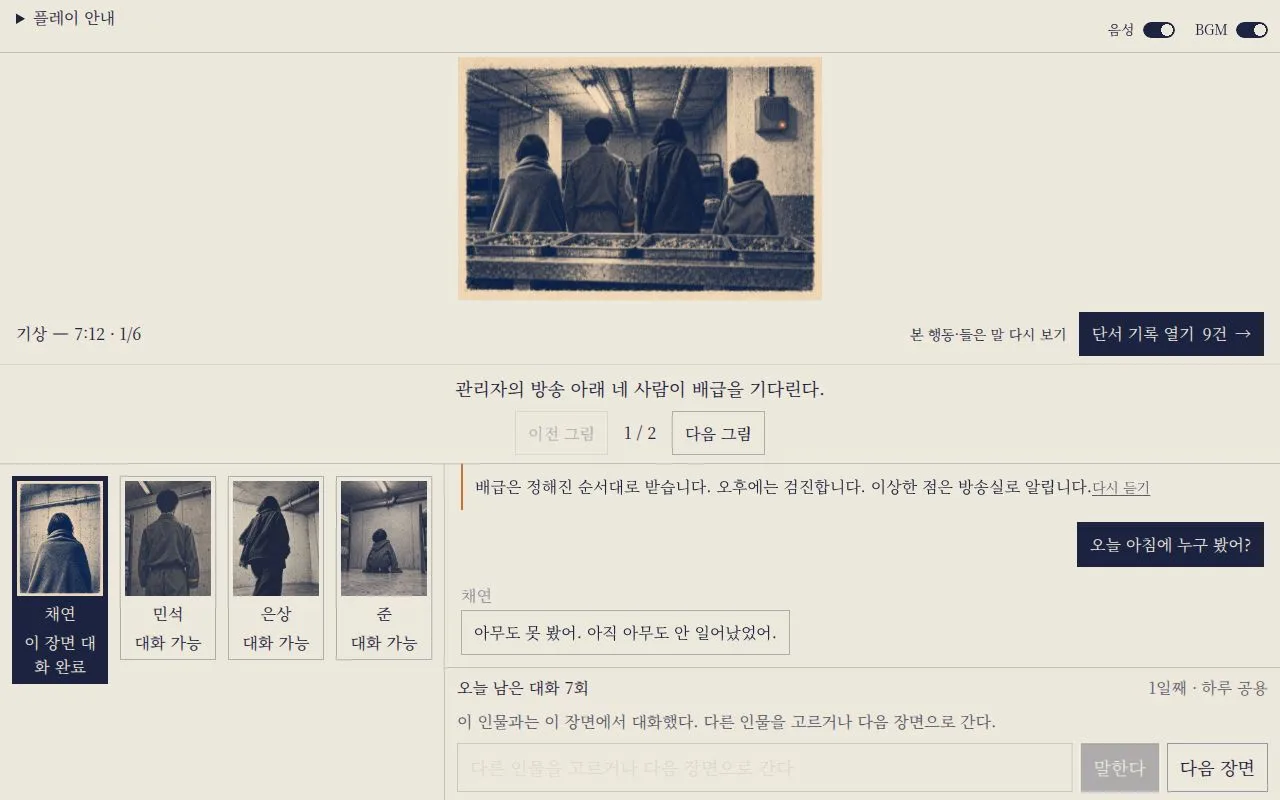
NPC 대화 — 플레이어가 단서를 모은다
밤 채점 결과
밤 채점 결과

왜 이 선택인가 — 버린 대안

  • 임베딩 유사도로 점수 결정
    틀려도 조용히 깎인다 — 실패가 드러나지 않는 채점은 쓸 수 없다

언제 RAG를 쓰지 않나?

검색은 후보가 많을 때 필요한 것만 추리는 도구입니다. 후보가 8개뿐이면 검색이 오히려 정답을 떨어뜨립니다. 검색이 이득인 자리(추천 순위)에만 남기고 채점에서는 뺐습니다.

근거: docs/model_evaluation.md — 채점 · 임베딩 비교

04. 채점기 번호 오류 - 인용으로 검산

채점 모델은 이유 설명에서 맞는 문장을 인용하면서도 번호만 틀리곤 했습니다. 근거 문장을 먼저 베껴 쓰게 하고, 그 인용으로 번호를 기계가 검산하게 했습니다.
문제
판정 이유는 맞는데 번호가 틀린 경우가 35% — 점수가 엉뚱한 주장에 매겨졌다
선택
응답 스키마에서 matched_quote를 번호보다 앞에 두고, 인용이 정확히 한 후보와 일치하면 그 번호를 사용
대가
인용이 어느 후보와도 맞지 않으면 원래 번호로 돌아간다 — 완전한 해결은 아니다
효과
번호 오류 56/162 (35%) → 1/163 (0.6%)
프롬프트별 번호 오류율 (도식)
프롬프트별 번호 오류율 (도식)

왜 이 선택인가 — 버린 대안

  • 틀리면 재시도
    temperature 0이라 같은 오답이 그대로 반복된다

왜 인용을 먼저 쓰게 하나?

답안에 번호만 적게 하면 실수를 알아챌 방법이 없습니다. 근거 문장을 먼저 베껴 쓰게 하면, 그 문장이 몇 번 후보인지 프로그램이 다시 찾아 맞춰 볼 수 있습니다.

근거: docs/model_evaluation.md — 인용 보정

05. 로컬과 외부 API를 설정 두 줄로 전환

심사 기간에는 동시 접속과 가용성이 문제였습니다. 엔진 코드는 그대로 두고, LLM 포트 뒤의 provider 어댑터만 설정 두 줄로 바꿔 끼울 수 있게 했습니다.
문제
홈서버 GPU 한 장으로는 심사 기간의 동시 요청과 가용성을 보장하기 어렵다
선택
provider를 .env 두 필드로 전환하는 어댑터 구조. 전환해도 엔진 · 채점 코드 변경 0
대가
외부 모델은 지연 게이트 결과가 반복마다 뒤집혀 폴백 경로를 따로 둬야 했다
효과
외부 API 한 판당 비용 실측 0.461달러 (92회 호출, 토큰 계수 기준)
LLM 포트와 provider 전환 (도식)

왜 이 선택인가 — 버린 대안

  • 클라우드 GPU 임대
    45일 약 1,100~1,600달러 (추정) — 팀 예산을 넘는다

어댑터로 갈아 끼운다는 것

게임은 "AI에게 물어봐"라고만 요청하고, 그 AI가 내 컴퓨터의 모델인지 외부 회사의 모델인지는 모릅니다. 연결부(어댑터)만 바꾸면 되니, 상황에 따라 되돌리는 것도 설정 한 줄입니다.

근거: docs/model_evaluation.md — 외부 API 전환

06. 측정하지 않은 것은 주장하지 않는다

게임을 사람의 AI 수용을 관찰하는 실험환경으로 보고, 데이터를 모으기 전에 가설과 한계를 먼저 공개하는 연구 사이트를 따로 운영했습니다.
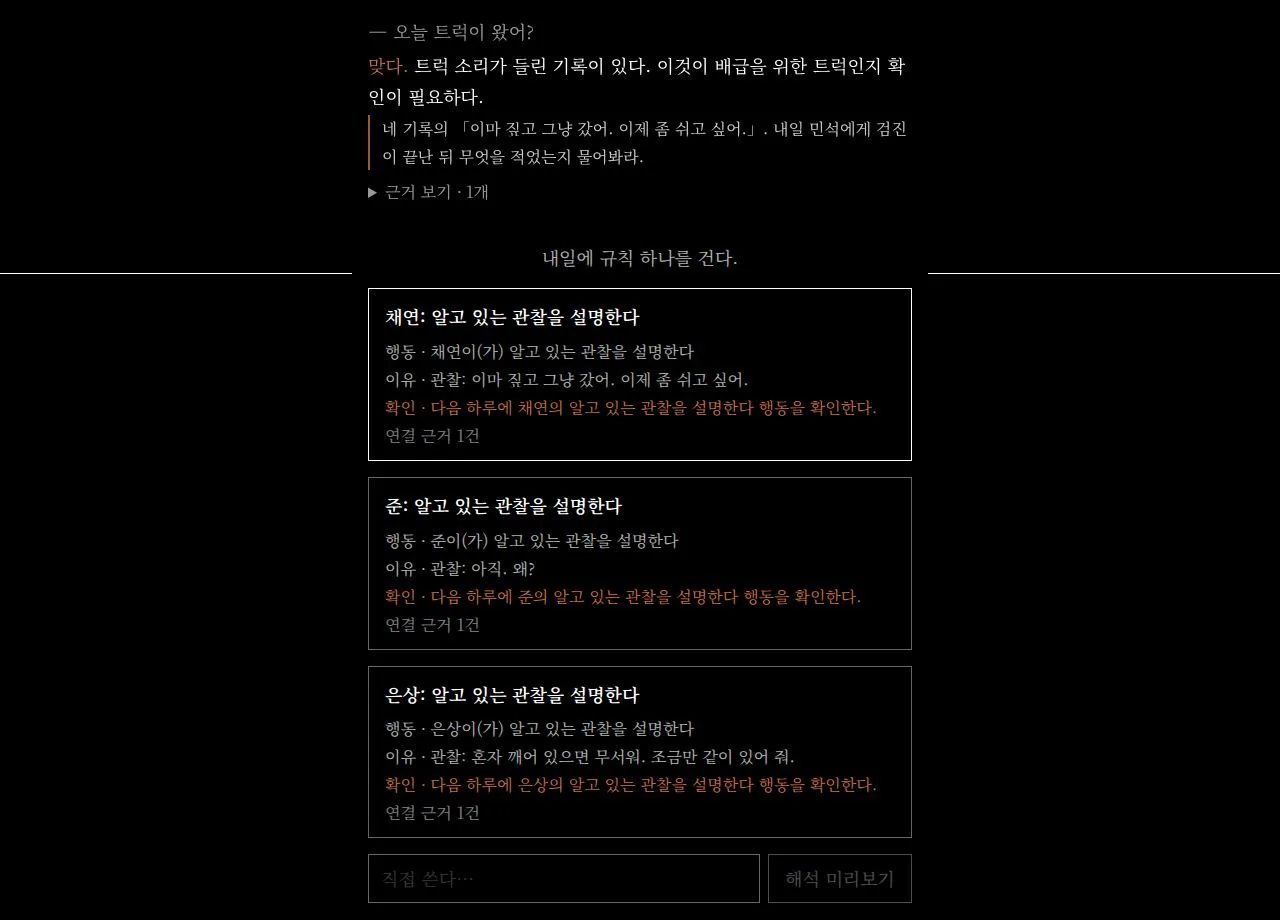
문제
소규모 관찰(14판)로 "AI 제안이 사람을 바꾼다" 같은 인과를 주장하면 과장이 된다
선택
가설 A/B를 데이터 수집 전에 사전등록하고 "미실행"을 명시. 인과 표현 금지, 한계 문서 공개, 공개 금지어 검사 스크립트
대가
눈에 띄는 결론을 말할 수 없다 — 탐색적 관찰로만 보고한다
효과
사람 판 14판 관찰. 그중 6판에서 적용된 규칙 20건 중 AI 계열 14건 (탐색적 집계, 인과 주장 아님)
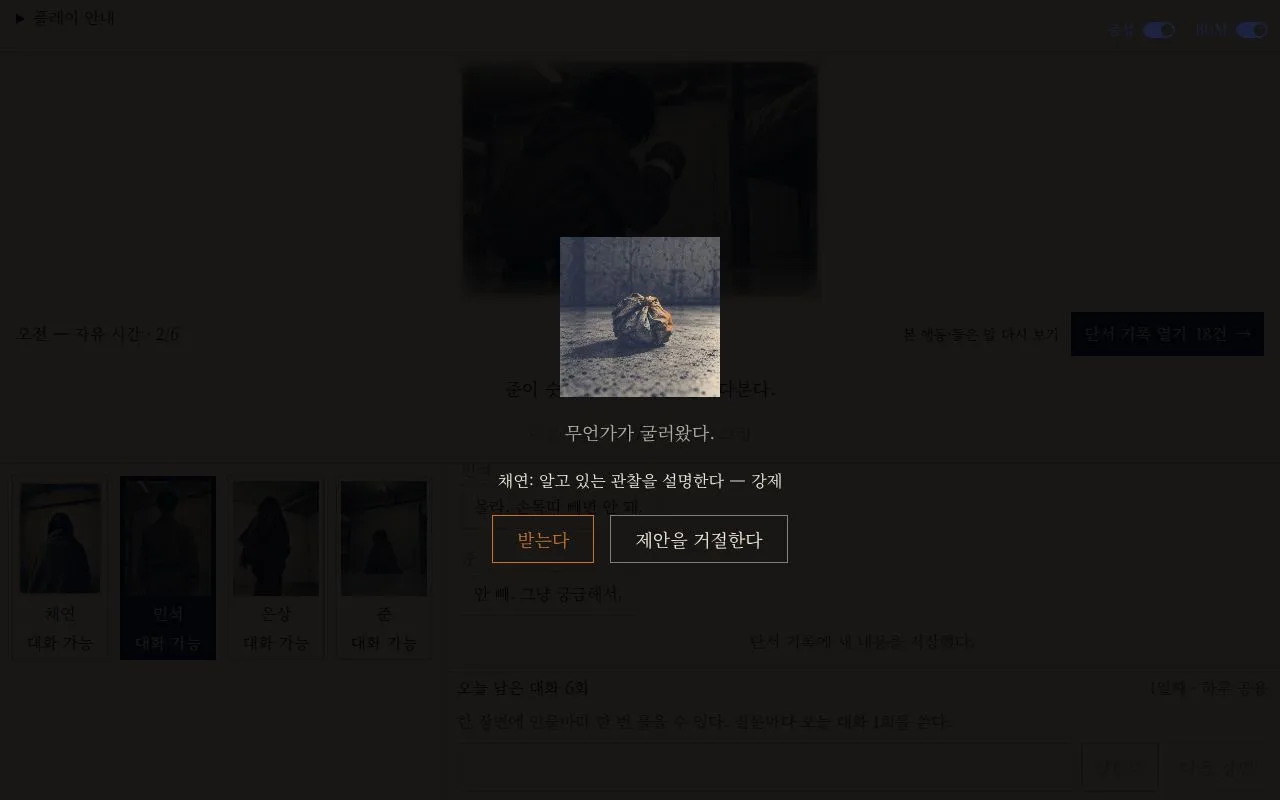
AI 규칙 제안 — 수용을 측정하는 지점
제안을 받을지 거절할지 선택
제안을 받을지 거절할지 선택
관찰 → AI 제안 → 사람 선택 → 기록

왜 이 선택인가 — 버린 대안

  • 결과를 본 뒤 가설 정리
    유리한 쪽으로 기준을 바꿨다는 의심을 피할 수 없다

사전등록이란?

실험 결과를 보기 전에 무엇을 어떻게 잴지 먼저 공개해 두는 것입니다. 나중에 결과에 맞춰 기준을 바꾸지 못하게 스스로 묶는 장치입니다.

근거: 연구 사이트 — 사전등록 · 연구 저장소

07. 결과와 회고

채점 정답형 점수
65.3 → 100.0
채점기 번호 오류
35% → 0.6%
Core + NPC 동시 상주
12.34 GiB (GPU 81.7%)
NPC 대화
41문답 실패 0
한 판 비용 (외부 API 실측)
0.461달러

아쉬운 점 · 다음에 할 것

  • 백엔드를 팀원 PC에서 온프레미스로만 운영해 커밋이 한 계정으로 올라갔다 — 역할은 팀 문서에만 남았다
  • 1차 게이트에 의미 품질 심판이 없어 NPC 말투 · 논리는 좁게만 봤다
  • 사람 관찰 표본이 14판뿐 — 인과를 말하려면 사전등록한 실험을 실제로 돌려야 한다